Pojawia się ogłoszenie: nowy „model” dorównuje najmocniejszym modelom na rynku w wybranych testach porównawczych. Po jednym dniu wszyscy chcą go wypróbować. Zanim przepniesz na niego swoją pracę, warto wiedzieć, co właściwie kupujesz. Bardzo często nie jest to mądrzejszy model, tylko menedżer, który rozdziela zadanie między modele, które już znasz. Pokażę ci, jak taki układ działa, jak go uczciwie sprawdzić i kiedy ma szansę się zwrócić.
Mała ryba, która rozdziela pracę
Przykład, na którym najłatwiej to pokazać, to Fugu i Fugu Ultra od Sakana AI, japońskiej firmy. „Sakana” po japońsku znaczy ryba, a logo pokazuje ławicę małych ryb, które razem układają się w jedną dużą. To dobra metafora całego pomysłu.
Z zewnątrz widzisz jedno API, czyli jeden punkt dostępu, do którego twój program wysyła polecenie i z którego dostaje odpowiedź. Za tym punktem siedzi jednak mały model zarządzający, wytrenowany do jednej rzeczy: rozłożyć zadanie na części i przekazać je modelom czołowych dostawców, takim jak Claude, GPT czy Gemini. Na przykład Claude dostaje pisanie, GPT kod i poprawki błędów, Gemini wyszukiwanie faktów. Przy trudniejszych zadaniach do puli mogą dochodzić kolejne modele.
Producent opisuje to jako system wielu agentów dostarczany jako jeden model. To uczciwy opis, tylko trzeba go dobrze przeczytać. Fugu nie jest nowym dużym modelem językowym, który przewyższa resztę. Deklaracja producenta brzmi tak: przez zestawianie istniejących modeli udało się na wybranych testach porównawczych uzyskać wyniki na poziomie najmocniejszych dostępnych modeli, takich jak Fable czy Mythos. To jest deklaracja, nie werdykt, i tak radzę ją traktować, dopóki nie sprawdzisz jej na własnej robocie.
Ten sam wzorzec znasz już z sub-agentów
Orkiestrator, czyli program koordynujący pracę kilku modeli, nie jest nową ideą. Jeśli pracujesz w Claude Code, widzisz ten wzorzec codziennie: główny agent rozbija plan, zleca części sub-agentom na tańszych lub mocniejszych modelach i składa wynik. Różnica w przypadku Fugu jest jedna. Zamiast koordynacji w obrębie modeli jednego dostawcy masz koordynację między dostawcami, a decyzję o podziale podejmuje wytrenowany model, nie ty.
Każda orkiestracja sprowadza się do dwóch pytań. Pierwsze: kto robi którą część. Masz zadanie złożone z kroków A, B i C, więc jeden model bierze A, drugi B i tak dalej. Drugie: kto to składa. Gdy poszczególne modele oddadzą swoje fragmenty, potrzebny jest jeszcze jeden model, który połączy je w jedną odpowiedź.
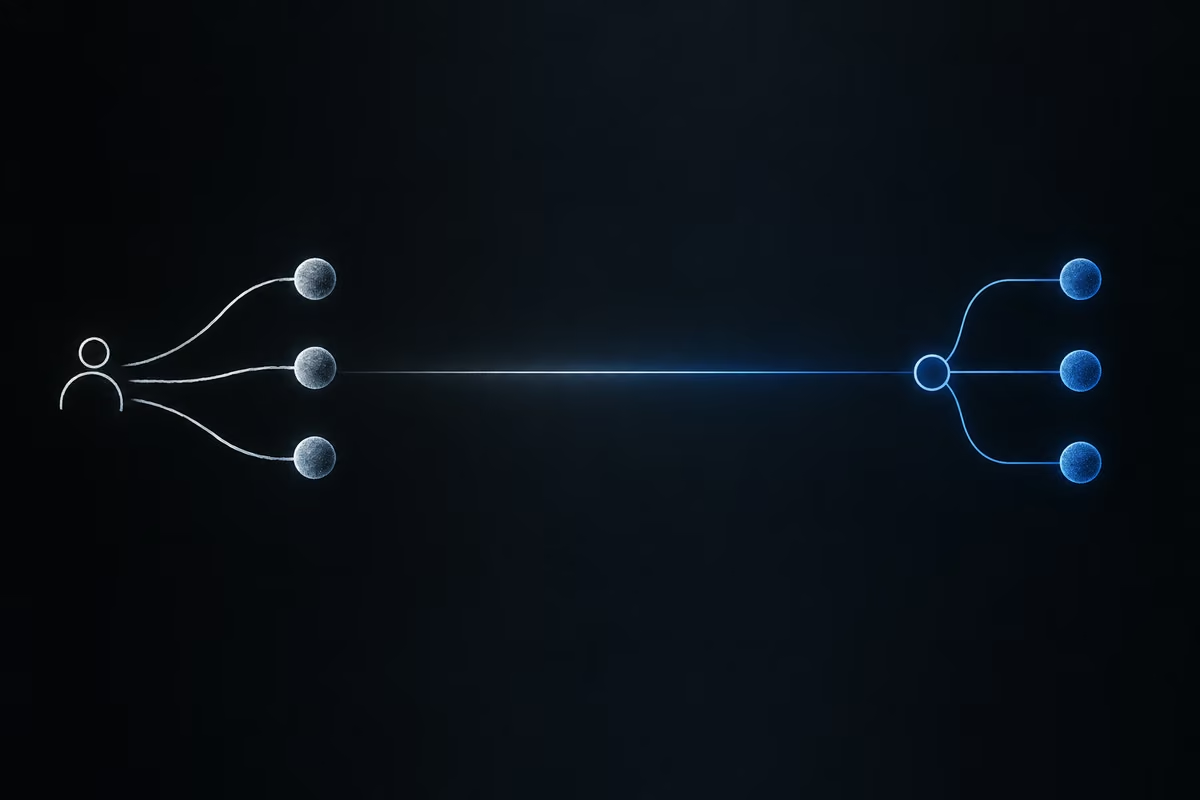
Pomaga myśleć o tym jak o osi. Na jednym końcu ty piszesz wszystko i sam decydujesz, który model robi co, na przykład planujesz w jednym narzędziu, a kod oddajesz do przeglądu w drugim. Na drugim końcu model decyduje o tym automatycznie. Orkiestrator za jednym API przesuwa cię na ten drugi koniec. Nie dodaje nowej zdolności, tylko zdejmuje z ciebie ręczne rozdzielanie.
Warto odróżnić to od innego wzorca, który krąży pod podobnymi hasłami. Można też wysłać to samo polecenie równolegle do trzech modeli i poprosić czwarty, żeby jako sędzia złożył najlepszą odpowiedź. Tak działa na przykład Fusion API w OpenRouter. Tam nikt nie dzieli zadania; wszyscy odpowiadają na całość. Oba podejścia mogą poprawiać jakość, bo różne modele wnoszą różne perspektywy. Oba płacą za to tym samym: czasem i pieniędzmi.
Jak uczciwie sprawdzić taką deklarację
Wynik producenta na wybranych testach nie mówi nic o twoich zadaniach. Żeby się czegoś dowiedzieć, porównanie musi spełniać kilka warunków.
Te same polecenia i te same dane wejściowe dla obu stron. Zadania z obiektywnym wynikiem typu zaliczone albo niezaliczone, a nie skala od jednego do dziesięciu, w której ocena odpływa w gust. Zestaw zróżnicowany: łamigłówki, zadania z pułapką, praca według specyfikacji, cięższe algorytmy. Oceniający niezależny od obu porównywanych systemów, najlepiej taki, który przygotował też zadania, żeby nikt nie układał testów pod siebie. I przede wszystkim pomiar trzech rzeczy, nie jednej: jakości, czasu i kosztu.
To ostatnie najczęściej wypada. Porównanie samej jakości zawsze wygląda niewinnie, bo orkiestrator, który korzysta z najlepszych modeli, rzadko wypadnie gorzej. Pytanie brzmi, ile kosztuje ten sam wynik.
Co pokazało porównanie na 38 zadaniach
W porównaniu na 38 zadaniach Fugu Ultra zestawiono z jednym modelem, Claude Opus 4.8. Zadania szły w czterech falach (łamigłówki, pułapki, specyfikacje, cięższe algorytmy), oba systemy dostały identyczne polecenia, a zadania przygotowało i oceniło osobne narzędzie, Codex, niezależne od obu stron. Rozliczenie szło przez API, czyli płatność za faktyczne użycie.
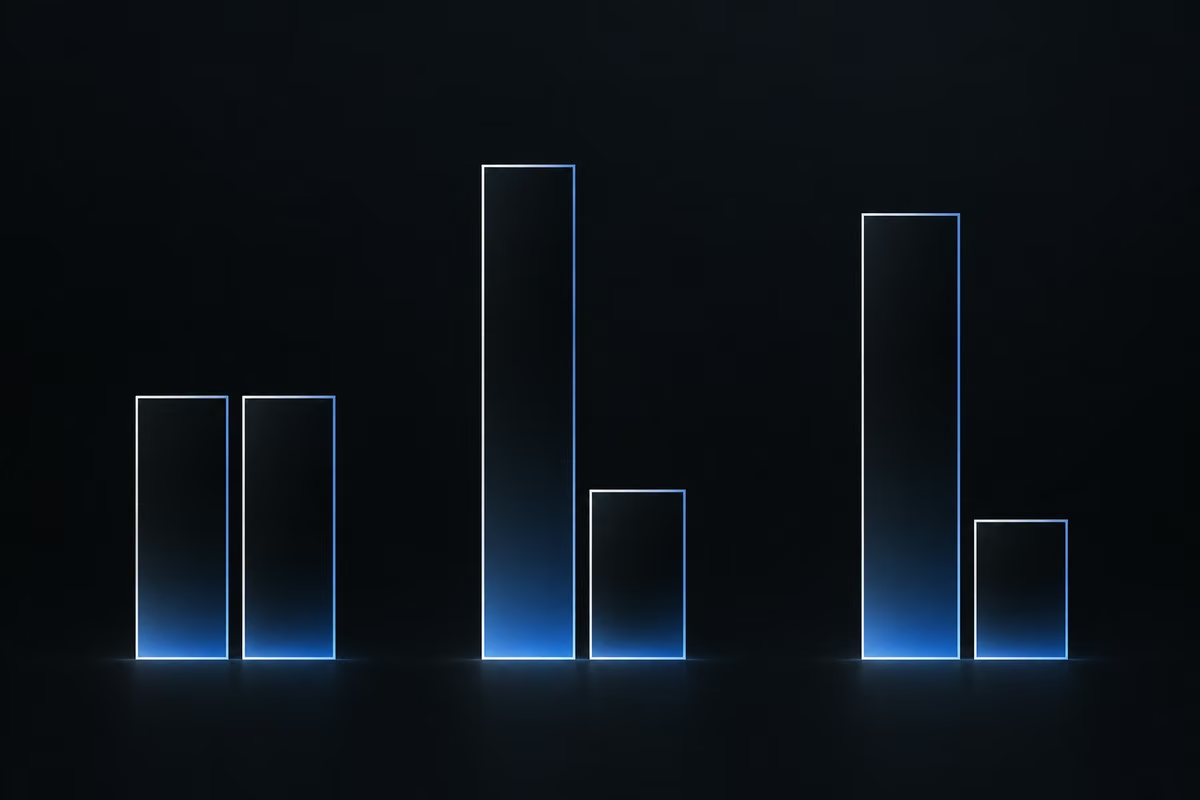
Wynik jakościowy: 36 z 38 zadań zakończyło się remisem. Pozostałe dwa wygrał pojedynczy model. Orkiestrator nie wygrał żadnego.
Czas: łącznie około 357 minut dla orkiestratora wobec około 80 minut dla pojedynczego modelu, czyli mniej więcej 4,5 raza dłużej. Najbardziej widać to na prostych zadaniach. Tam, gdzie pojedynczy model odpowiadał w kilka sekund, orkiestrator potrzebował kilku minut, bo nawet banalne polecenie przechodzi przez rozbicie, delegowanie i składanie.
Koszt: około 50 dolarów za całą serię orkiestratora wobec około 10 dolarów za pojedynczy model, czyli mniej więcej pięć razy drożej. Płacisz za kilka modeli naraz i za dłuższe przebiegi.
Jest tu jedno zastrzeżenie, które zmienia odczyt. Opus 4.8 jest jednym z modeli w puli, z której orkiestrator wybiera. Porównywano więc częściowo model z samym sobą, owiniętym w warstwę zarządzania. Remis w takim układzie nie dziwi. Drugie zastrzeżenie dotyczy zakresu: to były zadania przygotowane przez model, a nie wielotygodniowe przebudowy dużego kodu. Do takiej pracy ten test nie daje odpowiedzi.
Integracja i limity: rzeczy, których nie widać w ogłoszeniu
Orkiestrator dało się podłączyć do środowiska agenta, czyli programu, w którym model czyta pliki, uruchamia narzędzia i prowadzi zadanie do końca. W codziennej pracy z wiedzą, z researchem i własnymi skillami, działał poprawnie, tylko wolno. Podłączenie nie jest jednak zwykłą podmianą adresu i klucza, jak przy wielu innych modelach. Wymaga osobnej konfiguracji, a część zachowań wygląda inaczej niż zwykle: na przykład licznik zajętego kontekstu potrafił stać na zerze przez wiele rund rozmowy, bo odpowiedzi przychodzą z serwera orkiestratora.
Druga rzecz to limity. Dostęp jest w subskrypcji albo w rozliczeniu za użycie. Limity okienkowe w subskrypcji zapełniały się bardzo szybko, wyraźnie szybciej niż przy typowej subskrypcji środowiska agenta, nawet na wyższym planie. To naturalne, skoro każde polecenie uruchamia kilka modeli naraz.
Gdzie taki układ może się zwrócić
Nie twierdzę, że orkiestracja między dostawcami jest ślepą uliczką. Jest konkretny profil pracy, w którym może się opłacić: ciężka inżynieria oprogramowania, gdzie chcesz, żeby planował model jednego dostawcy, a przegląd robił model innego, i nie chcesz tego ręcznie spinać. Podobnie zespoły, w których wiele osób pracuje na jednej bazie kodu i już dziś używa dwóch narzędzi obok siebie. Jeśli i tak przełączasz się między nimi, jedno API może zdjąć z ciebie część tej roboty.
Przy pracy z wiedzą, pisaniu, researchu czy analizie, test nie dał powodu, żeby płacić więcej i czekać dłużej za tę samą jakość.
Lekcja, która zostaje niezależnie od narzędzia
Sam kierunek uważam za trafny. Nie zamykaj się w jednym dostawcy. Ucz się ekonomiki jednostkowej, czyli tego, ile kosztuje cię jedno wykonanie danego zadania, i szukaj najtańszego modelu, który dla tego zadania nie obniża jakości. Gdy modele drożeją, a najmocniejsze bywają czasowo niedostępne, ta umiejętność waży coraz więcej. Tylko że robisz to świadomie i na danych, a nie oddajesz w całości warstwie, której decyzji nie widzisz.
I zanim przełączysz się na cokolwiek, co według ogłoszenia dorównuje najlepszym, sprawdź to na własnej pracy: te same zadania, obiektywne kryteria, niezależna ocena, czas i koszt obok jakości.
Moja zasada jest prosta: warstwa zarządzania nie doda jakości ponad to, co potrafią jej wykonawcy. Za koordynację płacisz czasem i pieniędzmi, więc musi dawać coś, co da się zmierzyć na twoich zadaniach. Jeśli chcesz to sprawdzić przy najbliższym nowym narzędziu, zacznij od dziesięciu zadań, które znasz na pamięć, i zmierz wszystkie trzy wymiary.