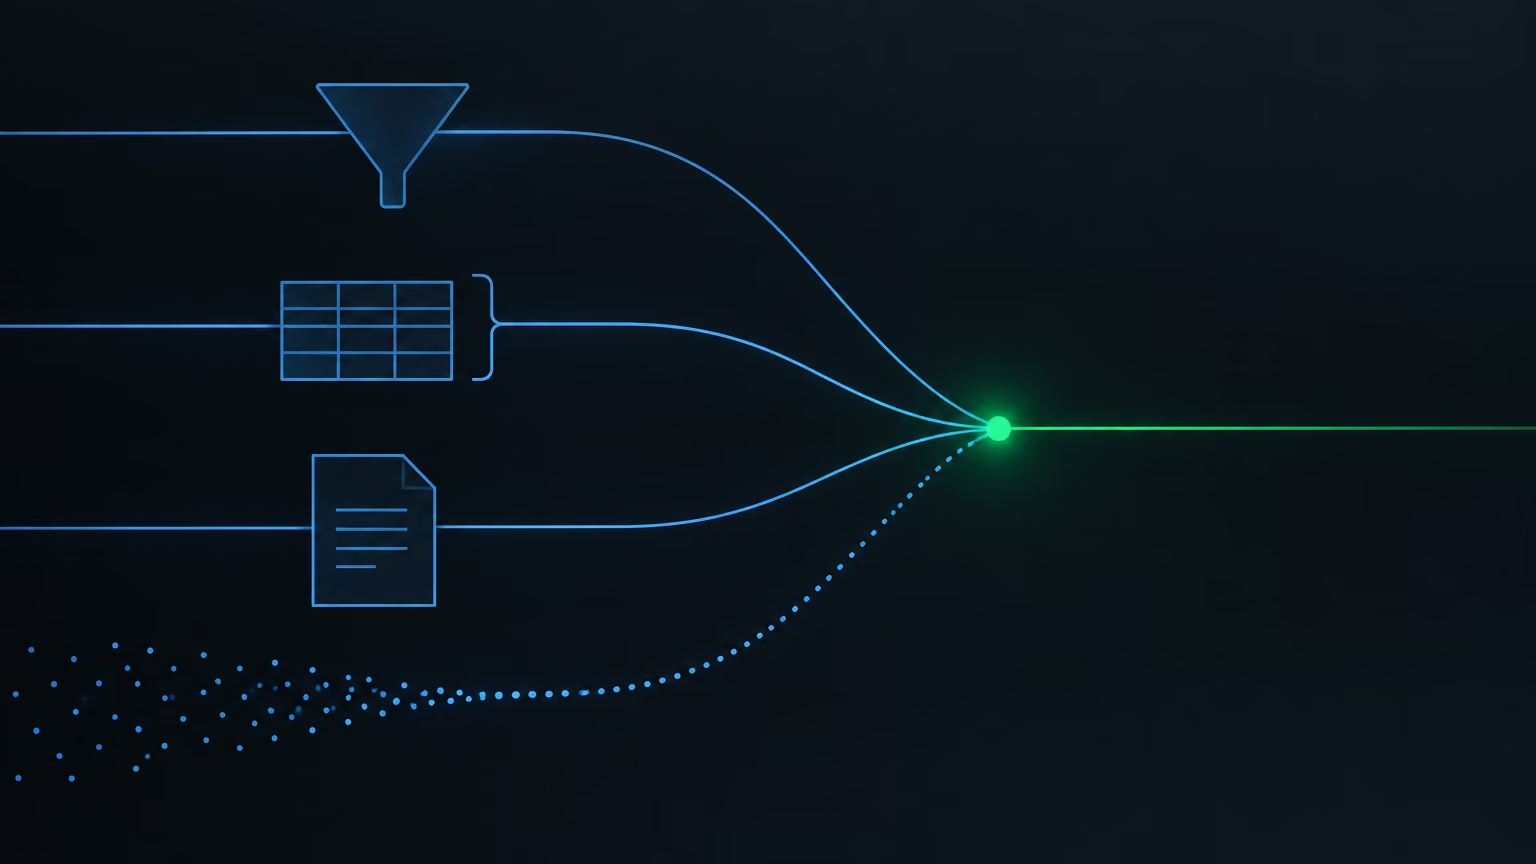
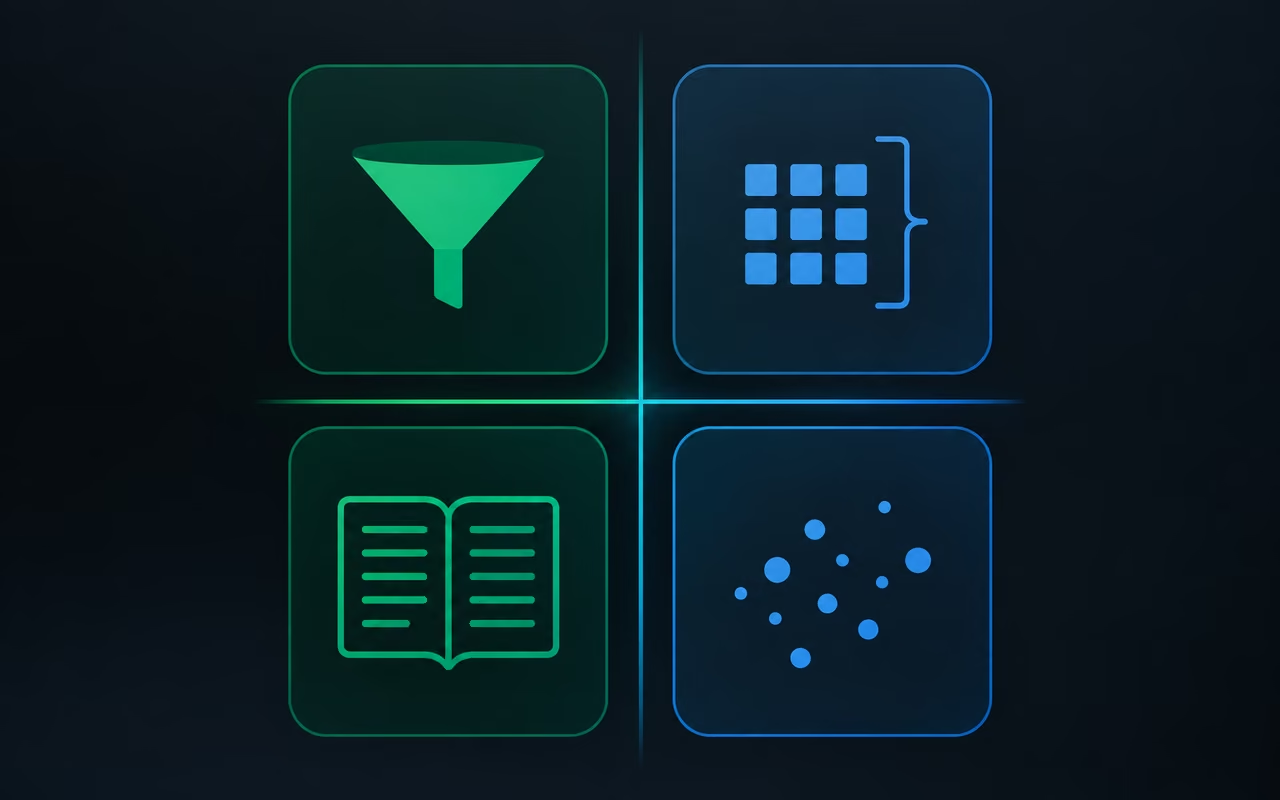
„Mój agent odpowiada źle. Jak to naprawić?” Na to pytanie nie da się odpowiedzieć jednym zdaniem, bo dźwigni jest dużo. Najczęściej jednak winny nie jest model, tylko sposób, w jaki agent sięga po wiedzę. Agent dostaje dane w formie, która nie pasuje do pytań, jakie mu zadajesz. Pokażę ci cztery metody pobierania wiedzy, każdą na prostym przykładzie, i podam regułę, po której poznasz, którą wybrać.
Najpierw pojęcie. RAG (z angielskiego retrieval-augmented generation) to po prostu sytuacja, w której agent przed odpowiedzią zagląda do zewnętrznych danych: tabeli sprzedaży, bazy kontaktów, dokumentu z procedurą. Samo „zagląda” może jednak oznaczać cztery bardzo różne rzeczy. Kiedy ktoś odkrywa, że jego agent potrzebuje zewnętrznej wiedzy, zwykle od razu sięga po bazę wektorową. Moim zdaniem to odruch, który częściej szkodzi, niż pomaga.
Dlaczego baza wektorowa nie jest domyślną odpowiedzią
Baza wektorowa działa tak: duży dokument jest cięty na małe fragmenty (po angielsku chunks). Każdy fragment zamienia się w ciąg liczb, który oddaje jego znaczenie, i trafia do bazy. Gdy agent dostaje pytanie, szuka fragmentów o podobnym znaczeniu i odpowiada na ich podstawie. To szybkie i tanie, bo agent czyta kilka kawałków zamiast całości.
Problem w tym, że fragment nie wie, skąd pochodzi. Dwudziestostronicowy plik PDF rozpada się na dziesiątki kawałków. Kiedy agent wyciąga jeden z nich, nie wie, z którego dokumentu pochodzi ani w którym miejscu tego dokumentu leżał. Da się to częściowo naprawić, dopisując do fragmentów metadane, ale to osobny temat. Skutek widać przy prostych prośbach. Poprosisz o streszczenie spotkania z 5 marca, a agent streści te fragmenty, które znalazł, a nie całe spotkanie.
Najgorzej jest z danymi w tabelach. Wyobraź sobie tabelę tygodniowej sprzedaży i pytanie: „W którym tygodniu sprzedaż była najwyższa?”. Agent szuka fragmentów pasujących do słów „najwyższa sprzedaż”, dostaje jeden kawałek tabeli i wybiera najlepszy tydzień z tego kawałka. Tymczasem w innych częściach tabeli były trzy tygodnie z wyższym wynikiem. Agent ich nie widział, więc odpowiedź brzmi pewnie i jest błędna. Tak samo z pytaniem o średnią wartość zamówienia: agent policzy średnią z zamówień, które trafiły do jednego fragmentu, a nie ze wszystkich.
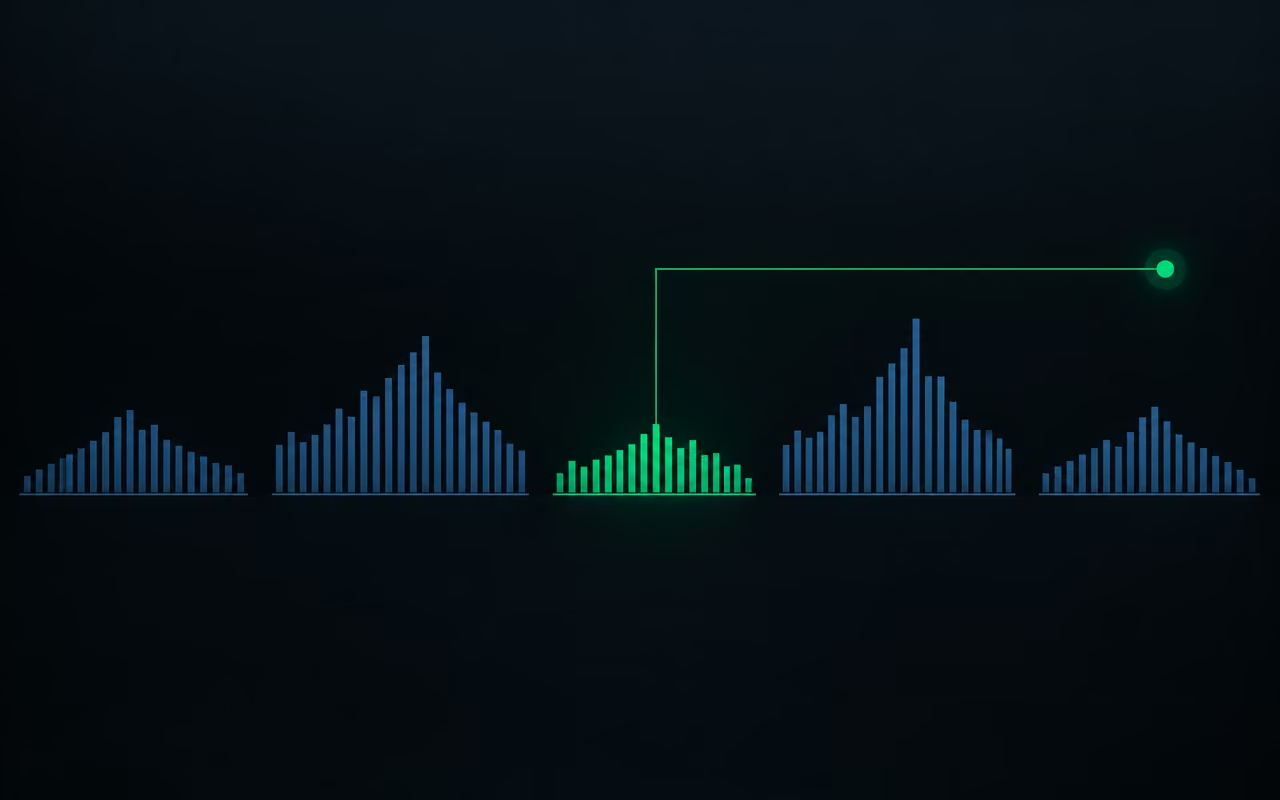
Dlatego zanim cokolwiek zbudujesz, zadaj dwa pytania. Jakie pytania dostanie ten agent? Na co musi patrzeć, żeby odpowiedzieć poprawnie? Od tych odpowiedzi zależy wybór metody.
Filtry: gdy człowiek przefiltrowałby arkusz
Weźmy prostą tabelę sprzedaży: nazwa produktu, data sprzedaży, cena, ilość. Pytasz agenta: „Ile głośników Bluetooth sprzedaliśmy 16 września?”. Dobrze zbudowany agent nie czyta całej tabeli. Najpierw zostawia tylko wiersze, w których produkt to głośnik Bluetooth. Potem z nich tylko te z 16 września. Zostają dwa wiersze, sumuje ilości i odpowiada. Dokładnie tak zrobiłby człowiek z arkuszem kalkulacyjnym.
Filtr to polecenie „daj mi tylko wiersze spełniające te warunki”. Sprawdza się, gdy dane mają postać wierszy i kolumn, wiesz z góry, po jakich polach filtrujesz, a odpowiedź leży w niewielkim podzbiorze rekordów. Jest szybki, tani i dokładny. Agent mógłby oczywiście przeczytać całą tabelę i też trafić. Tylko że wtedy przetwarza dużo więcej tekstu, więc płacisz więcej i rośnie ryzyko, że coś zmyśli. Chodzi o to, żeby do agenta trafiało tylko to, czego potrzebuje.
Jest tu pułapka, którą łatwo przeoczyć. Filtr nie szuka po znaczeniu, tylko sprawdza, czy wartość jest identyczna. Jeśli w tabeli produkt nazywa się „Bluetooth Speaker”, a agent wpisze w filtrze „bluetooth speaker”, dostaniesz zero wyników. Dlatego w instrukcji agenta trzeba wypisać dopuszczalne nazwy produktów, dokładnie w tej pisowni, jakiej używa baza, i podać format daty. To nie dzieje się samo. Gdy dodasz nową kategorię produktu albo zmienisz format daty, musisz zaktualizować instrukcję.
Reguła: jeśli człowiek użyłby filtrów w arkuszu, użyj filtrów.
Zapytanie SQL: gdy człowiek sięgnąłby po tabelę przestawną
Filtry przestają wystarczać, gdy pytanie wymaga liczenia na wielu wierszach. „Które trzy produkty przyniosły najwięcej przychodu?” To pytanie o sumy, grupowanie i ranking. Tu lepiej działa SQL, czyli język zapytań do baz danych. Agent sam układa zapytanie, a baza wykonuje obliczenia.
Takie zapytanie da się przeczytać prawie jak zdanie: wybierz produkty, zsumuj kwoty jako przychód, pogrupuj według produktu, posortuj malejąco, zostaw trzy pierwsze. Baza danych (na przykład Postgres, popularna baza, którą można mieć w usłudze typu Supabase) robi to szybko i bez pomyłek, bo do tego została zbudowana. Agent dostaje gotowy wynik zamiast setek wierszy. Jeśli potem chce policzyć coś dodatkowo, na przykład udział każdego produktu w całości, może jeszcze użyć kalkulatora. Główną pracę wykonała jednak baza.
SQL wybierasz, gdy potrzebujesz sum, średnich, rankingów albo trendów, gdy pytanie obejmuje wiele wierszy lub gdy porównujesz i łączysz dane. Jest pewniejszy niż kazanie modelowi czytać wszystkie wiersze i tańszy oraz dokładniejszy niż wyszukiwanie wektorowe na danych tabelarycznych.
Ta sama pułapka co przy filtrach wraca tu w innej formie. Agent musi znać strukturę tabeli: nazwy kolumn, co w nich jest, przykładowe wartości. Zwykle wpisujesz to w jego instrukcję. Jeśli dane często się zmieniają, możesz dać agentowi osobne narzędzie, którym przed zapytaniem sprawdzi aktualną strukturę bazy (jej schemat).
Reguła: jeśli człowiek użyłby tabeli przestawnej albo formuł, użyj SQL.
Pełny kontekst: gdy człowiek przeczytałby cały dokument
Teraz inny rodzaj danych: dwa długie dokumenty tekstowe, powiedzmy zapisy dwóch wystąpień, każdy na kilka stron. Prosisz agenta o chronologiczny przebieg jednego z nich. Przy wyszukiwaniu wektorowym agent dostałby kilka wyrwanych fragmentów i musiałby zgadywać ich kolejność. Prościej dać mu cały dokument.
Na tym polega metoda pełnego kontekstu: agent za każdym razem czyta całość, a nie wybrane kawałki. Zaleta jest oczywista. Ma pełny obraz, więc odpowiada dokładniej i zachowuje kolejność. Wady też są jasne. Przetwarza więcej tekstu, więc trwa dłużej i kosztuje więcej, a przy bardzo dużych zbiorach można dojść do limitu tego, ile model mieści naraz (okna kontekstu). Przy kilku dokumentach po kilka stron to dziś mały problem, bo okna kontekstu są duże i wciąż rosną, a modele coraz lepiej znajdują konkretną informację w długim tekście.
Pełny kontekst możesz podać na trzy sposoby:
- Jako narzędzie, które agent wybiera sam. Jeśli pytanie dotyczy jednego dokumentu, agent czyta tylko ten jeden. Jeśli obu, czyta oba. Płacisz za to, czego faktycznie potrzebował.
- Wklejony w instrukcję systemową. Agent nie musi wywoływać narzędzia, więc odpowiada szybciej. Za to czyta wszystko przy każdym pytaniu, także wtedy, gdy wystarczyłby jeden dokument. W porównaniu z wersją narzędziową zużycie tekstu na to samo pytanie wyraźnie rośnie.
- Podawany dynamicznie jako zmienne. Przy każdym pytaniu przepływ pobiera aktualne dokumenty i wstawia je do instrukcji. Koszt jest taki sam jak przy wklejeniu, ale gdy zmienisz dokument źródłowy, nie musisz poprawiać agenta.
Pełny kontekst wybierasz, gdy potrzebujesz streszczeń, osi czasu lub wyjaśnień krok po kroku, gdy kolejność informacji ma znaczenie albo gdy zbiór jest na tyle mały, że po prostu mieści się w modelu.
Reguła: jeśli człowiek przeczytałby cały dokument przed odpowiedzią, niech agent też go przeczyta. Osoba wdrażająca nowego pracownika musi znać całą procedurę. Osoba odpowiadająca na zgłoszenie klienta potrzebuje tylko jednego pytania z listy stu najczęstszych.
Wyszukiwanie wektorowe: kiedy jednak tak
Lista najczęstszych pytań to dobre miejsce dla bazy wektorowej. Kiedy te same dwa dokumenty trafią do bazy wektorowej i padnie to samo pytanie o chronologię, agent odpowie szybciej i zużyje wyraźnie mniej tekstu niż przy pełnym kontekście. Odpowiedź będzie jednak mniej dokładna. Agent dostaje kilka fragmentów i sam układa je w kolejności, która wydaje mu się sensowna. Często wychodzi to przyzwoicie, ale to jego domysł, nie kolejność z dokumentu. Możesz zwiększyć liczbę pobieranych fragmentów, na przykład z czterech do dwudziestu, i to pomaga, choć problemu nie usuwa.
Przewaga kosztowa rośnie razem z danymi. Przy dwóch dokumentach różnica jest umiarkowana. Przy tysiącach dokumentów czytanie wszystkiego za każdym razem przestaje mieć sens, a wyszukiwanie fragmentów zostaje tanie. Baza wektorowa sprawdza się więc przy dużych zbiorach tekstu, w których odpowiedź leży w jednym miejscu: w bazie wiedzy z najczęstszymi pytaniami, w dokumentacji, w regulaminach. Nie sprawdza się przy pytaniach o całość dokumentu ani przy liczeniu na tabelach.
| Pytanie, które dostaje agent | Rodzaj danych | Metoda | Co agent musi znać |
|---|---|---|---|
| „Ile sztuk X sprzedaliśmy w dniu Y?” | tabela, kilka rekordów | filtry | dopuszczalne wartości pól, format daty |
| „Które produkty zarobiły najwięcej?”, „Jaka jest średnia?” | tabela, wiele wierszy | SQL | nazwy kolumn, przykładowe wartości, schemat |
| „Streść całość”, „Ułóż chronologię” | kilka dokumentów tekstowych | pełny kontekst | które dokumenty są dostępne |
| „Co mówi regulamin o zwrotach?” | duży zbiór tekstów | wyszukiwanie wektorowe | ile fragmentów pobrać |
Zacznij od końca
Wszystkie cztery metody wynikają z jednej zasady: zaczynasz od końca. Zanim wybierzesz bazę, narzędzie czy model, wypisz pytania, które agent będzie dostawał, i przy każdym zapisz, na co musiałby spojrzeć człowiek, żeby odpowiedzieć poprawnie. Jeden wiersz? Suma z całej tabeli? Cały dokument od początku do końca? Jeden akapit z tysiąca stron? Odpowiedź wskaże metodę, a często także to, że jeden agent potrzebuje dwóch metod naraz: filtrów do tabeli zamówień i bazy wektorowej do dokumentacji.
Moim zdaniem większość źle działających agentów nie potrzebuje lepszego modelu. Potrzebują tego, żeby ktoś dopasował sposób szukania do rodzaju pytania. Weź swojego agenta, wypisz dziesięć prawdziwych pytań, które dostaje, i przy każdym zanotuj, jak odpowiedziałby na nie człowiek z dostępem do tych samych danych. Tam, gdzie te dwie drogi się rozjeżdżają, zaczynasz poprawki.